Post-Training für die eigene Aufgabe: SFT, Distillation und RL im Vergleich
Modelle trainieren
Dominik Keller
Gründer, Kontinent
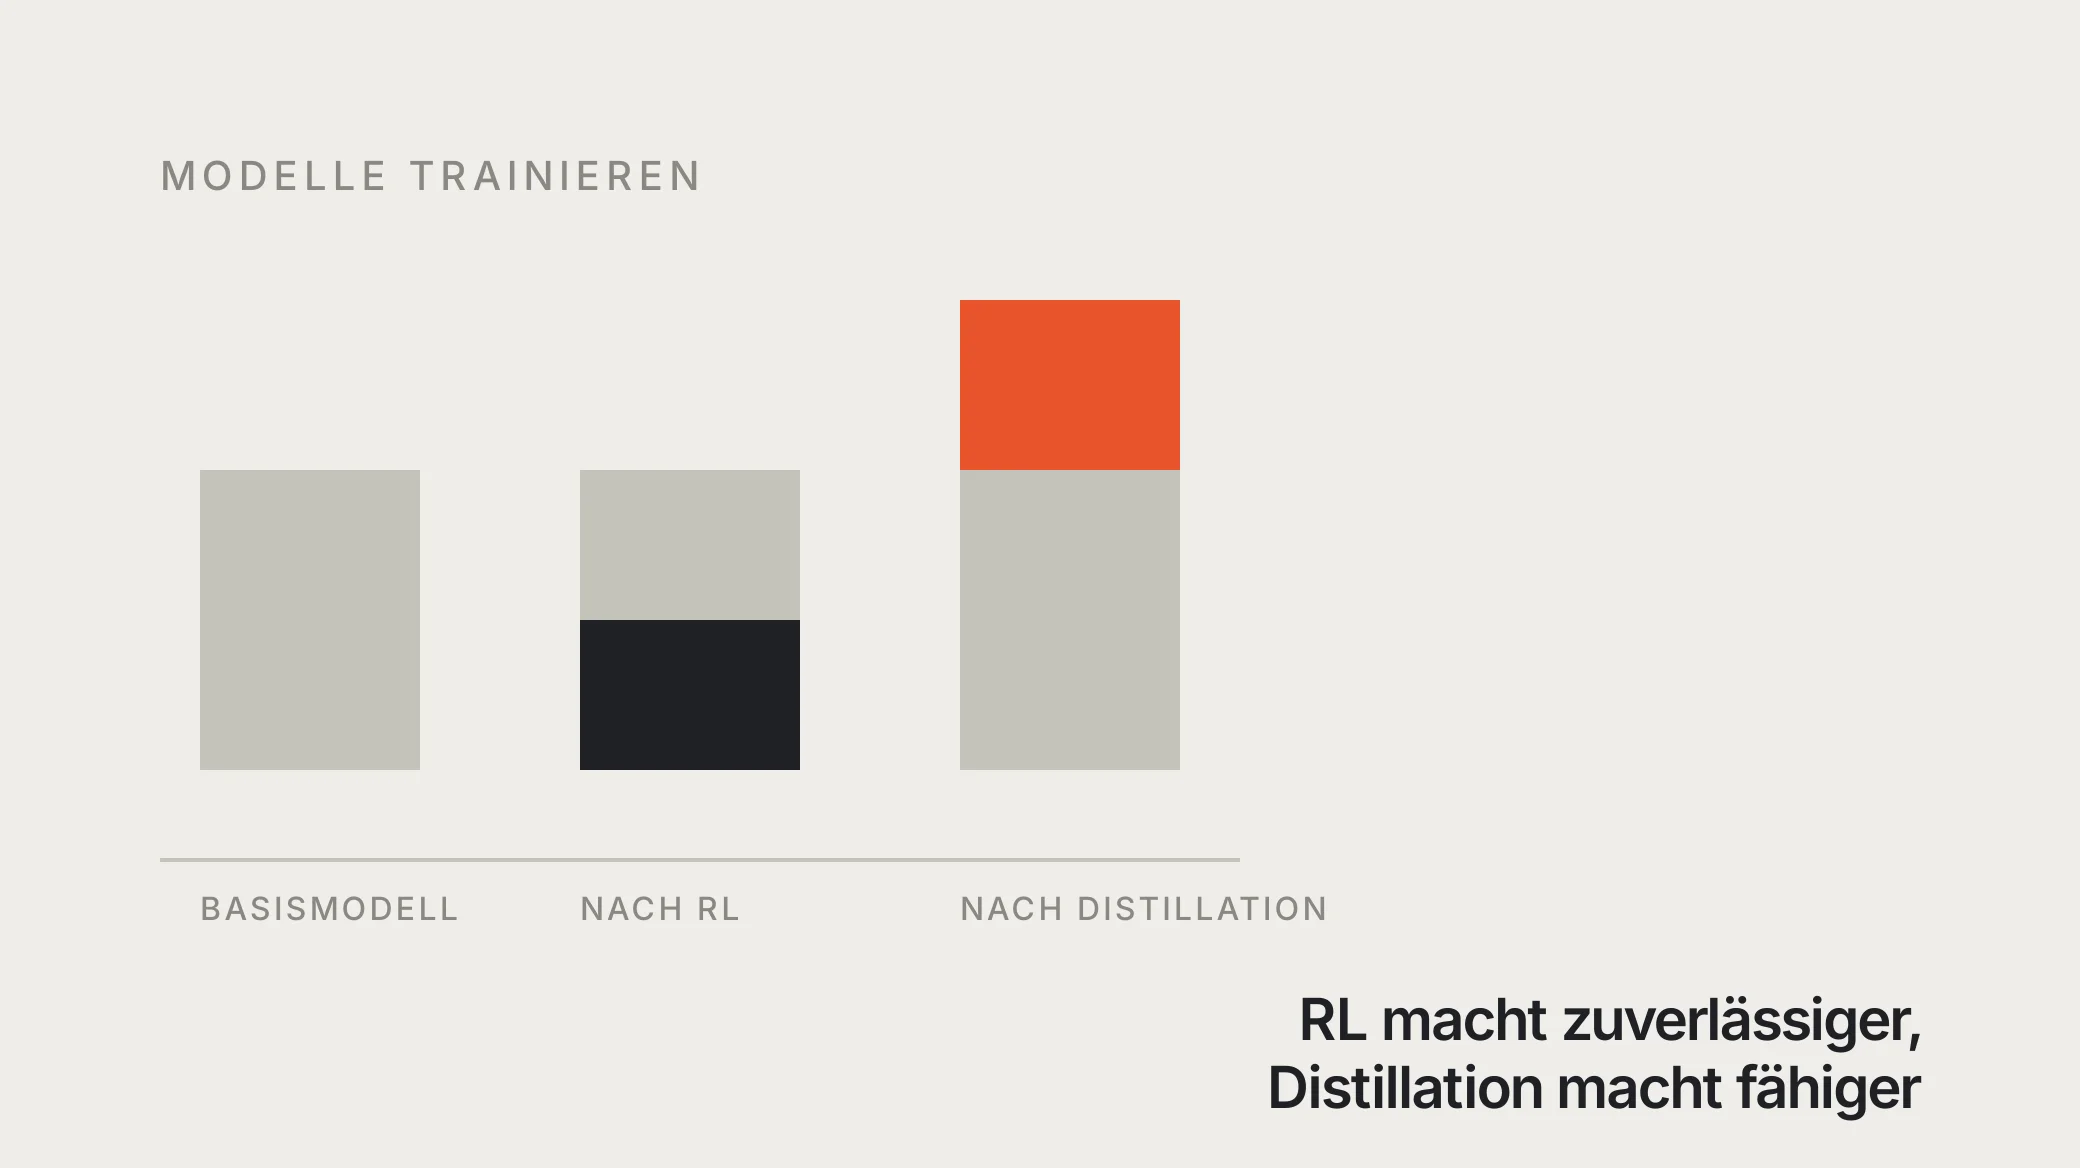
Post-Training passt ein fertiges Sprachmodell an Ihre Aufgabe an. Es gibt drei Grundverfahren. SFT lehrt das Modell Format und Verhalten aus Musterantworten. Distillation überträgt Fähigkeiten von einem größeren Modell und macht das kleine Modell damit fähiger. RL macht vorhandene Fähigkeiten zuverlässiger. Die meisten guten Rezepte kombinieren alle drei.
Wer ein eigenes Modell bauen will, hört schnell drei Abkürzungen: SFT, Distillation, RL. Sie klingen wie Alternativen, zwischen denen man wählt. Tatsächlich lösen sie verschiedene Probleme. Wer das falsche Verfahren nimmt, gibt Geld für Rechenzeit aus und misst danach keinen Fortschritt.
Dieser Beitrag erklärt, was jedes Verfahren am Modell verändert, woran Sie erkennen, welches Ihr Problem löst, und was es kostet. Er stützt sich auf die technischen Berichte von Qwen, DeepSeek und Ai2 sowie auf Studien und Berichte aus der Forschung, alle am 5. Oktober 2026 im Original nachgelesen. Ob sich Training für Ihre Aufgabe überhaupt lohnt, behandelt ein eigener Beitrag: Wann es sich lohnt, ein Modell zu fine-tunen.
Begriffe: Das Basismodell ist das Modell vor Ihrem Training. SFT (Supervised Fine-Tuning) ist Training auf vorgegebenen Musterantworten. Bei der Distillation lernt ein kleines Modell, der Student, von einem großen, dem Teacher. RL (Reinforcement Learning) heißt: Das Modell probiert Antworten aus und lernt aus deren Bewertung. pass@1 ist die Trefferquote beim ersten Versuch, pass@k der Anteil der Aufgaben, die in k Versuchen mindestens einmal gelöst werden. Eine GPU-Stunde ist eine Stunde Rechenzeit auf einer Grafikkarte.
Das Wichtigste in Kürze
Die drei Verfahren lösen drei verschiedene Probleme. SFT lehrt Format und Verhalten. Distillation erweitert, was das Modell überhaupt kann. RL macht zuverlässiger, was es schon kann.
RL hebt den Boden, Distillation die Decke. Im Qwen3-Bericht hob RL ein 8B-Modell beim ersten Versuch von 55,0 auf 67,6 Prozent. Bei 64 Versuchen blieb es exakt bei 90,0. Distillation hob beide Werte, auf 74,4 und 93,3 Prozent, wobei Letzteres genau eine gelöste Aufgabe mehr ist.
Für kleine Modelle ist Distillation oft billiger und besser als RL. Im selben Vergleich brauchte RL 17.920 GPU-Stunden, Distillation 1.800. DeepSeek kommt zum gleichen Schluss: Ein destilliertes 32B-Modell erreichte 72,6 Prozent, dasselbe Modell mit RL 47,0.
Training braucht weniger Daten als erwartet. Das s1-Modell wurde mit 1.000 Beispielen in 26 Minuten auf 16 GPUs trainiert. Zusammen mit einem Laufzeit-Trick übertraf es danach o1-preview bei Wettbewerbsmathematik.
Zwei offene Rezepte folgen derselben Reihenfolge. Tülu 3 und Olmo 3 trainieren erst mit SFT, dann mit Präferenztraining, dann mit RL auf prüfbaren Belohnungen. Qwen3 destilliert seine kleinen Modelle stattdessen aus den großen.
RL vergisst weniger als SFT. Eine Studie vom MIT zeigt: Bei gleicher Leistung auf der neuen Aufgabe behält ein Modell nach RL mehr von seinen alten Fähigkeiten.
Der bequeme Weg über OpenAI schließt sich. OpenAI fährt seine Fine-Tuning-Plattform herunter und nimmt keine neuen Nutzer mehr an. Das betrifft SFT, Präferenztraining und Reinforcement Fine-Tuning.
Inhaltsverzeichnis
Was Post-Training ist
Die drei Verfahren auf einen Blick
SFT: Das Modell lernt aus Musterantworten
Distillation: Ein großes Modell bringt einem kleinen etwas bei
RL: Das Modell lernt aus Bewertungen
Boden und Decke: Was RL und Distillation am Modell verändern
Welches Verfahren passt zu welchem Problem?
Die Reihenfolge der offenen Rezepte
Was die Verfahren kosten
Wo die Verfahren an Grenzen stoßen
Wie wir das mit Ihnen durchgehen
Häufige Fragen
Was Post-Training ist
Ein Sprachmodell entsteht in zwei Phasen. Im Pre-Training liest es riesige Textmengen und lernt, das nächste Wort vorherzusagen. Danach kann es Sprache, aber es folgt keinen Anweisungen. Im Post-Training lernt es, auf eine Frage hilfreich zu antworten, ein Format einzuhalten und eine Aufgabe zuverlässig zu lösen.
Pre-Training braucht riesige Rechencluster und bleibt deshalb großen Laboren vorbehalten. Post-Training dagegen ist der Teil, den Sie selbst machen können. Sie nehmen ein offenes Modell, das bereits Anweisungen folgt, und trainieren es weiter auf Ihre Aufgabe. Das Ergebnis ist ein kleines Modell, das genau eine Sache sehr gut kann, und dessen Weights Ihnen gehören.
Wie groß der Hebel ist, zeigte OpenAI schon 2022. Das 1,3-Milliarden-Modell InstructGPT, nachtrainiert mit SFT und RL, lieferte Antworten, die menschliche Bewerter denen des 175-Milliarden-Modells GPT-3 vorzogen. Das Modell war hundertmal kleiner.
Fundstelle: Ouyang et al. 2022, Abstract.
Die drei Verfahren auf einen Blick
Der Unterschied liegt darin, woher das Lernsignal kommt. Bei SFT ist es eine fertige Musterantwort. Bei Distillation ist es ein stärkeres Modell. Bei RL ist es eine Bewertung der eigenen Versuche.
Verfahren | Woher das Signal kommt | Was sich verbessert | Was Sie brauchen |
|---|---|---|---|
SFT | Musterantworten zu Beispielfragen | Format, Tonfall, Verhalten | einige Hundert bis wenige Tausend gute Beispiele |
Distillation | Antworten oder Wahrscheinlichkeiten eines Teachers | neue Fähigkeiten, die der Student vorher nicht hatte | einen starken Teacher, dessen Lizenz das erlaubt |
RL | Bewertung der eigenen Versuche durch einen Grader | Trefferquote beim ersten Versuch | einen Grader, der richtig und falsch zuverlässig unterscheidet |
Ein Grader ist dabei eine Prüfung, die eine Antwort bewertet. Das kann ein Programm sein, das ein Rechenergebnis vergleicht, ein JSON-Schema prüft oder Unit-Tests laufen lässt. Es kann auch ein anderes Modell sein oder ein Fachexperte.
SFT: Das Modell lernt aus Musterantworten
SFT ist das einfachste Verfahren. Sie zeigen dem Modell eine Frage und die Antwort, die Sie sich wünschen. Das Modell passt seine Weights so an, dass diese Antwort wahrscheinlicher wird. So übernimmt es Aufbau, Länge und Tonfall der Beispiele.
Erstaunlich ist, wie wenig Daten reichen. Das Forschungsteam hinter s1 trainierte ein Qwen2.5-32B-Instruct mit nur 1.000 sorgfältig ausgewählten Mathematikaufgaben samt Lösungsweg. Das Training dauerte 26 Minuten auf 16 H100-GPUs. Die Lösungswege hatte ein Gemini-Modell geschrieben. Streng genommen ist s1 damit schon ein Fall von Off-Policy-Distillation, wie sie der nächste Abschnitt beschreibt. Zusammen mit einem Trick zur Laufzeit, der das Modell länger nachdenken lässt, übertraf das Ergebnis OpenAIs o1-preview bei Wettbewerbsmathematik um bis zu 27 Prozent.
Fundstelle: Muennighoff et al., EMNLP 2025, Abstract, Einleitung und Abschnitt 2. Die 27 Prozent gelten mit „Budget Forcing“, nicht für das Training allein.
SFT hat zwei Schwächen. Die erste: Das Modell lernt, die Beispiele nachzuahmen, und verallgemeinert schlechter auf Fälle, die anders aussehen. Eine Studie, die beide Verfahren gezielt verglichen hat, fasst es so zusammen: SFT neigt dazu, Trainingsdaten auswendig zu lernen, RL verallgemeinert. Dieselbe Studie betont aber auch, dass SFT vor RL unverzichtbar bleibt, weil es das Ausgabeformat stabilisiert.
Die zweite Schwäche ist das Vergessen. Ein Modell, das stark auf eine neue Aufgabe trainiert wird, verliert oft Fähigkeiten, die es vorher hatte. Wie sich das bei SFT im Vergleich zu RL verhält, steht im Abschnitt über RL.
Fundstelle: Chu et al., ICML 2025, Abstract.
Distillation: Ein großes Modell bringt einem kleinen etwas bei
Bei der Distillation erzeugt ein großes Modell die Trainingsdaten für ein kleines. Die Idee ist alt. Hinton, Vinyals und Dean beschrieben 2015, wie sich das Wissen eines großen Modells in ein kleines übertragen lässt, das billiger zu betreiben ist.
Es gibt zwei Spielarten, und der Unterschied ist wichtig.
Off-Policy-Distillation ist im Kern SFT mit einem Teacher als Autor. Der Teacher beantwortet Tausende Fragen, und der Student lernt diese Antworten nach. Das ist einfach und funktioniert über jede API, die Texte liefert. Der Nachteil: Der Student sieht nur perfekte Lösungswege. Macht er im Einsatz einen eigenen Fehler, hat er nie gelernt, sich davon zu erholen.
On-Policy-Distillation dreht das um. Der Student schreibt selbst eine Antwort, und der Teacher bewertet jedes einzelne Wort darin. Der Student lernt also an seinen eigenen Fehlern, mit einer Rückmeldung für jedes Token statt einer einzigen Note am Ende. Ein Team von Google DeepMind hat das Verfahren 2024 vorgestellt. Es braucht für jeden Text des Students die Wahrscheinlichkeiten des Teachers, die Logprobs. Geschlossene APIs liefern die so nicht. Praktisch heißt das: Der Teacher muss ein offenes Modell sein, das Sie selbst laufen lassen, idealerweise mit demselben Tokenizer wie der Student.
Fundstelle: Hinton et al. 2015, Abstract. Agarwal et al., ICLR 2024, Abstract.
Wie stark Distillation wirkt, zeigt DeepSeek. Das Team verglich zwei Wege, ein Qwen-32B für Mathematik zu trainieren. Weg eins: RL direkt auf dem Modell, über 10.000 Trainingsschritte. Weg zwei: Distillation aus dem großen DeepSeek-R1. Auf der Mathematikprüfung AIME 2024 erreichte das RL-Modell 47,0 Prozent, das destillierte 72,6 Prozent.
Das Fazit der Autoren ist deutlich. Starke Modelle in kleinere zu destillieren liefert hervorragende Ergebnisse. Kleine Modelle mit großem RL zu trainieren kostet enorme Rechenleistung und erreicht die Distillation womöglich nicht einmal.
Fundstelle: DeepSeek-AI, DeepSeek-R1, arXiv-Fassung v1, Abschnitt 4.1 und Tabelle 6. Erschienen in Nature 645 (2025).
Bevor Sie einen Teacher wählen, prüfen Sie die Nutzungsbedingungen. Anthropic, OpenAI und Google verbieten es vertraglich, ihre Ausgaben zum Training konkurrierender Modelle zu verwenden. Welche Teacher erlaubt sind, haben wir einzeln ausgewertet: Welches Modell dürfen Sie als Teacher nutzen?
Fundstelle: Nutzungsbedingungen der drei Anbieter, ausgewertet mit Zitaten im verlinkten Beitrag.
RL: Das Modell lernt aus Bewertungen
Beim RL gibt es keine Musterantwort. Das Modell schreibt mehrere eigene Antworten auf dieselbe Frage. Ein Grader bewertet sie. Das Training macht die gut bewerteten Antworten wahrscheinlicher und die schlechten unwahrscheinlicher.
Drei Varianten begegnen Ihnen in der Praxis:
RLHF (RL from Human Feedback): Menschen vergleichen Antworten, daraus wird ein Bewertungsmodell trainiert, und dieses Bewertungsmodell dient als Grader. So wurde InstructGPT gebaut.
DPO (Direct Preference Optimization): Sie geben Paare aus besserer und schlechterer Antwort vor. Das Modell lernt direkt daraus, ohne eigene Versuche und ohne getrenntes Bewertungsmodell. Streng genommen ist das kein RL mehr, es erfüllt aber denselben Zweck.
RLVR (RL with Verifiable Rewards): Die Belohnung kommt aus einer prüfbaren Regel. Tülu 3 beschreibt das so: Das Modell wird nur belohnt, wenn seine Antwort nachweislich richtig ist. Für Extraktion, Klassifikation oder Code ist das die natürliche Wahl, weil sich dort richtig und falsch automatisch feststellen lassen.
Fundstelle: Ouyang et al. 2022, Abb. 2. Rafailov et al. 2023, Abstract. Lambert et al., Tülu 3, Abschnitt 6.
Ein verbreitetes RL-Verfahren für offene Modelle heißt GRPO. Es stammt aus der DeepSeekMath-Arbeit. GRPO lässt das Modell eine Gruppe von Antworten erzeugen und vergleicht jede mit dem Durchschnitt der Gruppe. Damit entfällt ein zweites Modell, das sonst den Wert jeder Antwort schätzen müsste, und das spart Speicher und Rechenzeit.
RL hat einen Vorteil, der in der Praxis viel wert ist: Es vergisst weniger. Ein Team vom MIT hat SFT und RL auf neuen Aufgaben verglichen, bei gleicher Leistung auf der neuen Aufgabe. Nach RL behielt das Modell seine früheren Fähigkeiten deutlich besser. Ihre Erklärung: RL bevorzugt Lösungen, die nahe am ursprünglichen Modell liegen. SFT kann sich beliebig weit davon entfernen.
Fundstelle: Shao et al. 2024, Abschnitt 4.1. Shenfeld et al., „RL's Razor“, Abstract.
Boden und Decke: Was RL und Distillation am Modell verändern
Das ist der wichtigste Abschnitt dieses Beitrags. Stellen Sie sich ein Modell vor, das jede schwere Aufgabe 64-mal versucht. Die Decke ist der Anteil der Aufgaben, die es in diesen 64 Versuchen wenigstens einmal löst. Sie zeigt, was das Modell grundsätzlich kann. Der Boden ist die Trefferquote beim ersten Versuch. Er zeigt, wie zuverlässig es das abruft.
RL hebt den Boden. Die Decke bewegt es kaum. Ein Team der Tsinghua-Universität hat das an Mathematik, Code und Bildaufgaben über mehrere Modellfamilien gemessen. Modelle nach RL gewinnen beim ersten Versuch. Bei sehr vielen Versuchen erreicht das untrainierte Basismodell dagegen den höheren Wert. Nach dieser Studie bringt RL in seiner heutigen Form keine neuen Lösungswege. Es sorgt dafür, dass das Modell die richtige Antwort, die es schon kennt, öfter zuerst wählt.
Distillation hebt die Decke. Dieselbe Studie hält fest: Anders als RL bringt Distillation neue Lösungsmuster vom Teacher mit und erweitert damit tatsächlich, was das Modell kann.
Fundstelle: Yue et al., NeurIPS 2025, Abstract und Abschnitt 4.2.
Der Qwen3-Bericht zeigt dasselbe Muster in einem direkten Vergleich. Beide Verfahren starten vom selben 8B-Checkpoint, der bereits durch eine erste Off-Policy-Distillation gelaufen ist. Verglichen wird also RL gegen eine zweite, On-Policy-Distillation.
Qwen3-8B | AIME'24 pass@1 | AIME'24 pass@64 | AIME'25 pass@1 | GPU-Stunden |
|---|---|---|---|---|
Startpunkt (nach Off-Policy-Distillation) | 55,0 % | 90,0 % | 42,8 % | nicht angegeben |
+ RL | 67,6 % | 90,0 % | 55,5 % | 17.920 |
+ On-Policy-Distillation | 74,4 % | 93,3 % | 65,5 % | 1.800 |
RL hob den Boden um 12,6 Punkte, die Decke blieb stehen. Distillation hob den Boden um 19,4 Punkte, mit einem Zehntel der Rechenzeit. Bei der Decke ist Vorsicht angebracht: AIME'24 hat 30 Aufgaben, das Plus von 3,3 Punkten ist genau eine zusätzlich gelöste Aufgabe. Die belastbarere Stütze für den Decken-Effekt ist die Tsinghua-Studie oben.
Fundstelle: Qwen Team, Qwen3 Technical Report, Abschnitt 4.7 und Tabelle 21.
Welches Verfahren passt zu welchem Problem?
Aus Boden und Decke folgt eine einfache Diagnose. Lassen Sie das Basismodell Ihre schwersten Fälle viele Male lösen und zählen Sie, wie oft es trifft. Das kostet Stunden, nicht Wochen, und es entscheidet die Methodenwahl, bevor Sie Geld für Training ausgeben. Wie Sie den Test aufsetzen, steht im Beitrag Wann es sich lohnt, ein Modell zu fine-tunen.
Was Sie beobachten | Was das bedeutet | Verfahren |
|---|---|---|
Die Antworten stimmen inhaltlich, aber Format oder Tonfall passen nicht | Verhaltensproblem | erst Prompt und Schema prüfen, dann SFT |
Das Modell löst einen schweren Fall in vielen Versuchen nie | Die Fähigkeit fehlt, die Decke ist zu niedrig | Distillation von einem stärkeren Teacher |
Das Modell löst schwere Fälle manchmal, aber nicht zuverlässig | Die Fähigkeit ist da, der Boden ist zu niedrig | RL mit einem prüfbaren Grader, oder On-Policy-Distillation |
Das Modell löst fast alles schon beim ersten Versuch | Kein Modellproblem | kein Training, das Problem liegt in Daten, Prompt oder Prozess |
Dem Modell fehlt Faktenwissen aus Ihren Dokumenten | Wissensproblem | Retrieval statt Training |
Bei der dritten Zeile stehen zwei Verfahren zur Wahl. RL braucht keinen Teacher, aber einen Grader. On-Policy-Distillation braucht einen offenen Teacher, den Sie selbst betreiben, ist laut Qwen3-Bericht aber bei kleinen Modellen deutlich günstiger. Haben Sie einen erlaubten Teacher, der die Aufgabe besser löst als Ihr Student, ist Distillation meist der erste Versuch. Ist Ihr Student schon so gut wie jeder verfügbare Teacher, bleibt RL.
Die Reihenfolge der offenen Rezepte
Die offenen Labore veröffentlichen ihre Trainingsrezepte vollständig. Daran lässt sich ablesen, wie die Verfahren zusammenspielen.
Tülu 3 von Ai2 trainiert Llama 3.1 in drei Stufen: SFT, dann DPO, dann RLVR. Das Ergebnis übertraf laut Bericht die Instruct-Fassungen von Llama 3.1 und Qwen 2.5 sowie GPT-4o-mini und Claude 3.5 Haiku. Olmo 3 folgt demselben Dreischritt. Die Logik dahinter: SFT bringt das Format, DPO den Stil und RLVR die Treffsicherheit bei prüfbaren Aufgaben.
Qwen3 geht für die kleinen Modelle einen anderen Weg. Die großen Flaggschiffe durchlaufen vier Trainingsstufen. Die kleinen Modelle werden stattdessen aus den großen destilliert. Das liefert laut Bericht bessere Werte beim ersten Versuch und bei 64 Versuchen, mit einem Zehntel der GPU-Stunden des vierstufigen Verfahrens.
Fundstelle: Lambert et al., Tülu 3, Abstract. Ai2, Olmo-3-Ankündigung vom 20.11.2025. Qwen Team, Qwen3 Technical Report, Abschnitt 4.
Für ein Unternehmensprojekt mit einem kleinen offenen Modell ergibt sich daraus eine praktische Reihenfolge:
Baseline messen. Basismodell und ein starkes Frontier-Modell auf Ihrem Testset, mit fairem Prompt.
SFT oder Off-Policy-Distillation auf einigen Hundert bis wenigen Tausend Beispielen. Das bringt Format und den größten Teil des Sprungs.
On-Policy-Distillation oder RL, wenn der Boden danach noch zu niedrig ist.
Nachmessen, auch auf allgemeinen Fähigkeiten und Sicherheit, nicht nur auf der Zielaufgabe.
Was die Verfahren kosten
Die Rechenzeit unterscheidet sich um Größenordnungen. Am günstigsten ist SFT auf wenigen Beispielen, am teuersten RL auf einem Modell, das die Aufgabe noch kaum beherrscht.
Beispiel | Verfahren | Rechenzeit | Grob in Euro |
|---|---|---|---|
s1, Qwen2.5-32B-Instruct, 1.000 Beispiele | SFT auf Teacher-Lösungen | 26 Minuten auf 16 H100, also rund 7 GPU-Stunden | rund 20 € |
Qwen3-8B, Mathematik und Code | On-Policy-Distillation | 1.800 GPU-Stunden | rund 5.000 € |
Qwen3-8B, Mathematik und Code | RL | 17.920 GPU-Stunden | rund 50.000 € |
Die Euro-Spalte ist eine Größenordnung, keine Rechnung. Sie setzt für jede GPU-Stunde den günstigsten europäischen H100-Listenpreis von 2,80 Euro an, aus unserem Vergleich GPU-Preise in Europa. Der Qwen3-Bericht nennt den GPU-Typ nicht. Die Qwen-Läufe sind zudem Forschungsläufe auf breiten Mathematik- und Code-Datensätzen. Ein Projekt auf einer einzelnen, eng umrissenen Unternehmensaufgabe braucht weit weniger.
Fundstelle: Muennighoff et al., Abschnitt 3. Qwen Team, Tabelle 21.
Der größere Kostenblock ist oft nicht das Training, sondern die Daten. Bei Distillation zahlen Sie für jede Antwort des Teachers. Bei RL zahlen Sie für den Grader, und wenn Fachexperten bewerten, für deren Zeit. Thinking Machines hat On-Policy-Distillation mit klassischem SFT auf Teacher-Antworten verglichen. Je nachdem, ob die Teacher-Kosten schon bezahlt sind, sparte das Verfahren dort das Neunfache, rund das 18-Fache oder rund das 30-Fache.
Fundstelle: Thinking Machines Lab, „On-Policy Distillation“, 27.10.2025, Abschnitt zur Recheneffizienz. Blogbeitrag, nicht begutachtet.
Wo Sie in Europa trainieren können und welche Wege es neben eigenen GPUs gibt, steht in LLM-Fine-Tuning in Europa.
Wo die Verfahren an Grenzen stoßen
Jedes Verfahren hat eine typische Stelle, an der Projekte scheitern. Wer sie vorher kennt, plant sie ein.
Training auf eigenen Dokumenten zerstört Verhalten. Thinking Machines trainierte ein Qwen3-8B auf internen Dokumenten, damit es deren Inhalt kennt. Das Wissen stieg von 18 auf 43 Prozent. Gleichzeitig fiel die Fähigkeit, Anweisungen zu folgen, von 85 auf 45 Prozent. Mit einem Anteil allgemeiner Chat-Daten im Training und einer anschließenden On-Policy-Distillation kam das Modell auf 41 Prozent Wissen und 83 Prozent Anweisungstreue. Die Lehre: Nach jedem Training auf Fachtexten gehört das allgemeine Verhalten nachgemessen und meist repariert.
Fundstelle: Thinking Machines Lab, Abschnitt „Distillation for personalization“, Tabelle zu Mid-Training.
RL ist nur so gut wie sein Grader. Ein Grader, der falsche Antworten durchlässt, bringt dem Modell bei, genau diese Lücke auszunutzen. Bauen Sie den Grader deshalb wie ein Testset: aus echten Fällen, von Fachexperten geprüft, und vor dem Training gegen Beispiele getestet. Wie das geht, beschreibt der Evals Guide.
Distillation ist rechtlich gebunden. Der beste Teacher ist oft vertraglich gesperrt. Offene Modelle mit freier Lizenz sind die Alternative. Ob eines davon Ihre Aufgabe besser löst als Ihr Student, zeigt erst eine Messung auf Ihrem Testset.
Der verwaltete Weg schließt sich. OpenAI fährt seine Fine-Tuning-Plattform herunter. Neue Nutzer erhalten keinen Zugang mehr, bestehende trainierte Modelle laufen weiter, bis ihr Basismodell abgekündigt wird. Reinforcement Fine-Tuning gab es dort ohnehin nur für o4-mini. Mistral hat sein Fine-Tuning ebenfalls abgekündigt. Wer heute ein Post-Training-Projekt beginnt, landet damit fast immer bei einem offenen Modell.
Fundstelle: OpenAI, Reinforcement Fine-Tuning Guide und Supervised Fine-Tuning Guide, abgerufen am 05.10.2026. Mistral, Fine-Tuning-Dokumentation, abgerufen am 05.10.2026.
Personenbezogene Daten im Training brauchen eine Rechtsgrundlage. Das gilt für SFT-Beispiele genauso wie für RL-Prompts. Was dabei nach DSGVO und AI Act zu beachten ist, steht in KI-Modelle auf eigenen Daten trainieren.
Wie wir das mit Ihnen durchgehen
Die Diagnose aus diesem Beitrag kann Ihr Team selbst durchführen. Schwierig ist selten das Verfahren. Schwierig ist ein Testset, dem Sie hinterher glauben, und ein Grader, der richtig von falsch unterscheidet.
Genau dort setzen wir an. Wir bauen mit Ihnen ein Testset aus Ihren echten Fällen, mit Ihren Fachexperten als Grader. Dann messen wir Boden und Decke Ihres Basismodells und wählen danach das Verfahren, nicht vorher.
Trainiert und betrieben wird auf dedizierten GPUs in der EU, ohne US-Hyperscaler in der Kette. Weights, Eval-Set und Dokumentation gehören Ihnen, mit Export jederzeit. Kein Modell geht ohne Eval-Gate in den Betrieb, jeder Rollout läuft als A/B-Test mit Rollback. Der AVV steht vor dem ersten Datensatz.
Der erste Schritt ist ein Gespräch über Ihre Aufgabe: 30 Minuten, Engineering ist dabei, kein Pitch. Wenn dabei herauskommt, dass ein Prompt Ihr Problem löst und kein Training, sagen wir das. Termin vereinbaren.
Häufige Fragen
Was ist der Unterschied zwischen Fine-Tuning und Post-Training?
Post-Training ist der Oberbegriff für alles, was nach dem Pre-Training mit einem Modell passiert. Fine-Tuning meint im Alltag meist SFT, also Training auf Musterantworten. Distillation und RL gehören ebenfalls zum Post-Training. Wer „Fine-Tuning“ sagt, meint deshalb oft nur einen Teil dessen, was möglich ist.
Brauche ich RL, wenn SFT schon gute Ergebnisse liefert?
Nicht unbedingt. Messen Sie nach dem SFT die Trefferquote beim ersten Versuch und bei vielen Versuchen. Liegen beide nahe beieinander und hoch genug, bringt RL wenig. Liegt der erste Versuch deutlich unter dem Wert bei vielen Versuchen, kann RL diese Lücke schließen. Es macht zuverlässiger, was das Modell schon kann.
Ist Distillation dasselbe wie SFT?
Off-Policy-Distillation ist technisch SFT, nur stammen die Musterantworten von einem Teacher-Modell statt von Menschen. On-Policy-Distillation ist etwas anderes. Dort schreibt der Student selbst, und der Teacher bewertet jedes Token. Das ähnelt RL, mit einer viel feineren Rückmeldung als einer einzigen Note am Ende.
Wie viele Trainingsbeispiele brauche ich?
Für SFT reichen oft einige Hundert bis wenige Tausend gute Beispiele. Das s1-Modell kam mit 1.000 aus, OpenAI empfiehlt in seinem Fine-Tuning-Guide 50 als Startpunkt. Qualität zählt mehr als Menge. Für RL brauchen Sie keine Musterantworten, aber genug Aufgaben mit einem Grader, der zuverlässig bewertet.
Welches Modell eignet sich als Teacher?
Eines, das Ihre Aufgabe deutlich besser löst als Ihr Student, und dessen Nutzungsbedingungen Distillation erlauben. Die großen US-Anbieter verbieten das Training konkurrierender Modelle mit ihren Ausgaben. Offene Modelle mit freier Lizenz wie Apache 2.0 sind die sichere Wahl, wenn sie stark genug sind.
Verliert mein Modell durch Training allgemeine Fähigkeiten?
Das kann passieren und heißt Vergessen. Es ist bei SFT stärker als bei RL, wie eine Studie vom MIT zeigt. Gegenmittel sind allgemeine Daten im Trainingsmix und eine kurze On-Policy-Distillation am Ende. Messen Sie nach jedem Lauf auch allgemeine Fähigkeiten und Sicherheit, nicht nur die Zielaufgabe.
Quellen
Qwen Team, „Qwen3 Technical Report“ (arXiv:2505.09388): Strong-to-Weak-Distillation und der direkte Vergleich mit RL in Tabelle 21
DeepSeek-AI, „DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning“ (Nature 645, 2025): Distillation gegen RL auf einem 32B-Modell
Yue et al., „Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?“ (NeurIPS 2025, Oral): pass@k, Boden und Decke
Lambert et al., „Tulu 3: Pushing Frontiers in Open Language Model Post-Training“ (arXiv:2411.15124): das Rezept SFT, DPO, RLVR
Muennighoff et al., „s1: Simple test-time scaling“ (EMNLP 2025): SFT auf 1.000 Teacher-Lösungen, also Off-Policy-Distillation
Shenfeld, Pari, Agrawal, „RL's Razor: Why Online Reinforcement Learning Forgets Less“ (arXiv:2509.04259): Vergessen bei SFT und RL
Chu et al., „SFT Memorizes, RL Generalizes“ (ICML 2025): Verallgemeinerung und die Rolle von SFT vor RL
Agarwal et al., „On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes“ (ICLR 2024): On-Policy-Distillation
Hinton, Vinyals, Dean, „Distilling the Knowledge in a Neural Network“ (arXiv:1503.02531): Ursprung der Distillation
Ouyang et al., „Training language models to follow instructions with human feedback“ (arXiv:2203.02155): InstructGPT und RLHF
Rafailov et al., „Direct Preference Optimization“ (arXiv:2305.18290): Präferenztraining ohne RL-Schleife
Shao et al., „DeepSeekMath“ (arXiv:2402.03300): Einführung von GRPO
Thinking Machines Lab, „On-Policy Distillation“ (27.10.2025): Kostenvergleich und Personalisierung
Ai2, Olmo 3 (20.11.2025): dreistufiges Post-Training-Rezept
OpenAI, Reinforcement Fine-Tuning Guide und Supervised Fine-Tuning Guide: Modelle, Mindestbeispiele und Abkündigung der Plattform. Dazu die Mistral Fine-Tuning-Dokumentation mit dem Abkündigungshinweis
The Evals Guide: Testsets und Grader bauen
Stand: 5. Oktober 2026 · kontinent.ai. Alle Prozentwerte stammen aus den genannten Veröffentlichungen und gelten für die dort getesteten Modelle und Aufgaben, überwiegend Mathematik und Code. Die Euro-Werte sind Größenordnungen auf Basis öffentlicher Listenpreise. Anbieterseiten wurden am 5. Oktober 2026 abgerufen und ändern sich.
