LLM-Fine-Tuning in Europa: Wo Sie trainieren, was es kostet, wem die Gewichte gehören
Modelle trainieren
Dominik Keller
Gründer, Kontinent

„In Europa fine-tunen" heißt drei Dinge, die unabhängig voneinander wahr oder falsch sein können: wo Ihre Trainingsdaten während des Laufs liegen, wo die GPUs stehen und wem am Ende die Gewichte gehören. Es gibt vier Wege, und sie unterscheiden sich vor allem im dritten Punkt. Eine H100-Stunde kostet bei europäischen Spezialanbietern ab 2,80 Euro, bei den Hyperscalern in ihren eigenen EU-Regionen das Zwei- bis Dreifache.
Die meisten Gespräche über europäische KI hören bei der Datenresidenz auf. Für Inferenz ist das auch die richtige Frage: Welche Region, welcher AVV, welche Aufbewahrungsfrist. Beim Training verschiebt sie sich. Ein fertig trainiertes Modell ist eine Datei. Wer diese Datei hat, kann das Modell betreiben, kopieren, verkaufen und in fünf Jahren noch laden, wenn der Anbieter längst abgeschaltet hat.
Dieser Beitrag ist die Landkarte dazu. Er zeigt die vier Wege, ein Modell in Europa zu trainieren, mit Preisen, die wir am 21. September 2026 direkt aus den Preisverzeichnissen der Anbieter gezogen haben, mit den Basismodellen, deren Lizenz das erlaubt, und mit der Frage, die am Ende über die Souveränität entscheidet. Ob sich Fine-Tuning für Sie überhaupt lohnt, ist eine andere Frage, die wir an anderer Stelle beantwortet haben.
Das Wichtigste in Kürze
Drei Dinge müssen getrennt geprüft werden: Trainingsdaten, Rechenkapazität und Gewichte. Viele Angebote decken zwei davon ab und schweigen zum dritten. Der dritte ist der, der bleibt.
Europäische Spezialanbieter sind deutlich günstiger als die Hyperscaler in deren EU-Regionen. Eine H100-Stunde kostet bei OVHcloud 2,80 Euro und bei Scaleway 2,87 Euro. Azure verlangt in Deutschland 7,79 Euro, AWS in Stockholm umgerechnet 6,42 Euro. Bei Acht-GPU-Systemen wird der Abstand größer, nicht kleiner.
AWS führt für Frankfurt gar keine H100-Instanz. Im On-Demand-Preisverzeichnis für eu-central-1 gibt es als schnellste Trainings-GPU nur die A100 aus der p4d-Familie. H100 bekommen Sie in der EU bei AWS in Stockholm, H200 in Spanien.
Rechenzeit ist der billigste Teil. Ein QLoRA-Lauf auf einem 70B-Modell passt nach gängiger Speicherrechnung auf eine einzelne H100 und kostet in Europa eine niedrige zweistellige Summe. Teuer sind Datenaufbereitung und Evals.
Ein Anbieter kann den Weg unter Ihnen wegziehen. OpenAI baut seine Fine-Tuning-Plattform gerade zurück: keine neuen Nutzer mehr, bestehende können laut Dokumentation noch „for the coming months" Jobs starten. Wer die Gewichte nicht hat, hat kein Modell.
Es gibt genug europäische Basismodelle unter Apache 2.0, von Mistral Large 3 über Apertus bis EuroLLM. Ein europäisches Modell ist trotzdem keine Voraussetzung. Was zählt, ist die Lizenz und wo Sie es betreiben.
Inhaltsverzeichnis
Was „in Europa trainieren" konkret heißt
Die vier Wege im Überblick
Weg 1: Managed Fine-Tuning-API
Weg 2: GPU-Stunden bei einem europäischen Anbieter
Weg 3: EuroHPC AI Factories
Weg 4: Eigene Hardware
Welche Maschine ein Lauf wirklich braucht
Was ein Trainingslauf am Ende kostet
Welches Basismodell Sie nehmen können
Wo die Gewichte liegen, und warum das die eigentliche Frage ist
Was der AI Act daran ändert
Evaluation: messen Sie auf Deutsch
Wie wir das mit Ihnen durchgehen
Häufige Fragen
Was „in Europa trainieren" konkret heißt
Ein Trainingslauf berührt drei Orte, und ein Anbieter kann bei zwei davon europäisch sein und beim dritten nicht.
Der erste Ort ist Ihr Datensatz. Er verlässt Ihr Haus, landet in einem Object Storage und wird von dort in den Trainingsprozess geladen. Hier gelten dieselben Fragen wie bei jeder Auftragsverarbeitung: Region, AVV, Löschfristen, Unterauftragnehmer. Der zweite Ort ist die GPU selbst, also das Rechenzentrum, in dem der Lauf stattfindet. Der dritte Ort ist der Speicherort der fertigen Gewichte, und über den steht in vielen Angeboten schlicht nichts.
Diese Trennung ist kein Formalismus. Sie erklärt, warum zwei Anbieter, die beide „DSGVO-konform" und „EU-Rechenzentrum" auf die Seite schreiben, am Ende zu völlig unterschiedlichen Abhängigkeiten führen. Bei dem einen laden Sie nach dem Lauf eine Datei herunter. Bei dem anderen bekommen Sie einen Endpoint und eine Modell-ID.
Die vier Wege im Überblick
Weg | Wie schnell startklar | Bekommen Sie die Gewichte? | Wann sinnvoll |
|---|---|---|---|
Managed Fine-Tuning-API | Stunden | Meist nein, je nach Anbieter | Erster Versuch, unklarer Nutzen, kein MLOps-Team |
GPU-Stunden bei einem EU-Anbieter | Tage | Ja, die Datei liegt bei Ihnen | Der Normalfall für produktive Projekte |
EuroHPC AI Factory | Wochen (Antrag) | Ja | KMU und Startups mit großem Rechenbedarf und Zeit |
Eigene Hardware | Monate | Ja, samt Blech | Dauerlast, strenge Auflagen, kein Datenabfluss erlaubt |
Die meisten Unternehmen, mit denen wir sprechen, landen bei Weg 2. Weg 1 ist der vernünftige Einstieg, wenn noch niemand weiß, ob Training überhaupt hilft. Weg 3 ist unterschätzt, hat aber enge Zugangsbedingungen. Weg 4 rechnet sich seltener, als er diskutiert wird.
Weg 1: Managed Fine-Tuning-API
Sie laden eine JSONL-Datei hoch, wählen ein Basismodell, starten einen Job und bekommen wenig später eine Modell-ID, die Sie wie jedes andere Modell ansprechen. Kein Cluster, kein Scheduler, keine CUDA-Version. Das ist der schnellste Weg von einer Idee zu einer messbaren Antwort.
Bezahlt wird nach Trainings-Tokens. Fireworks staffelt nach Modellgröße: 0,50 US-Dollar pro Million Tokens für Modelle bis 16B Parameter, 10,00 US-Dollar jenseits von 300B. Together liegt je nach Modell bei 0,34 bis 40,00 US-Dollar pro Million Tokens, mit einer Mindestgebühr pro Job. Mistral verlangt für seine Classifier-Modelle 1 US-Dollar pro Million Trainings-Tokens, mindestens 4 US-Dollar pro Job und 2 US-Dollar Speichergebühr pro Modell und Monat. Die zugehörige Dokumentationsseite trägt allerdings seit einiger Zeit einen Deprecation-Hinweis, Mistral verweist für Custom Models inzwischen auf ein eigenes Angebot.
OpenAI fehlt in dieser Aufzählung, und der Grund ist lehrreich. In der eigenen Dokumentation steht inzwischen: „OpenAI is winding down the fine-tuning platform. The platform is no longer accessible to new users, but existing users of the fine-tuning platform will be able to create training jobs for the coming months." Bereits trainierte Modelle bleiben für Inferenz erreichbar, bis ihr Basismodell abgekündigt wird. Die Preise stehen weiter im Preisverzeichnis, 3,00 US-Dollar pro Million Trainings-Tokens für gpt-4o-mini und 25,00 US-Dollar für gpt-4.1. Für ein neues Projekt sind sie ohne Bedeutung, weil Sie nicht mehr hineinkommen.
Für ein europäisches Projekt hat dieser Weg zwei Haken, und der zweite ist der größere.
Der erste ist der Anbieterstandort. Together und Fireworks sind US-Unternehmen. Datenresidenz in der EU ist bei einigen buchbar, aber sie ist eine Konfiguration, kein Standardzustand, und sie ändert nichts an der Frage, wem das Unternehmen untersteht. Wir haben die vier üblichen Bezugswege für US-Modelle an anderer Stelle durchgerechnet.
Der zweite Haken hängt damit direkt zusammen: Ohne Gewichte lebt Ihr Modell am Lebenszyklus eines fremden Unternehmens. Es existiert nur als Modell-ID in einem System, das Sie nicht kontrollieren, und wenn dieses System zurückgebaut wird, ist der Trainingsaufwand verloren. Das ist keine hypothetische Sorge. Sie steht im Absatz darüber. Bei Plattformen für offene Modelle sieht es meist besser aus, dort können Sie die LoRA-Adapter häufig herunterladen. Das ist der Punkt, den Sie vor dem ersten Job klären sollten, nicht nach dem dritten.
Wenn Sie Trainingsdaten von einem großen Modell erzeugen lassen wollen, kommt eine weitere Ebene dazu: Die Nutzungsbedingungen der Frontier-Anbieter verbieten das für konkurrierende Modelle. Welche Klausel wo steht, haben wir im Volltext verglichen.
Weg 2: GPU-Stunden bei einem europäischen Anbieter
Sie mieten eine Maschine, laden Ihren Datensatz hoch, lassen Axolotl, torchtune oder ein eigenes Skript laufen und laden am Ende ein Verzeichnis mit Gewichten herunter. Etwas mehr Arbeit als Weg 1, und der Unterschied im Ergebnis ist Eigentum.
Preise ändern sich, deshalb hier der Stand mit Datum. Wir haben die folgenden Werte am 21. September 2026 aus den Preisverzeichnissen der Anbieter selbst geholt, bei OVHcloud aus dem öffentlichen Bestellkatalog für Deutschland, bei Azure aus der Retail-Prices-API, bei AWS aus der Price-List-API.
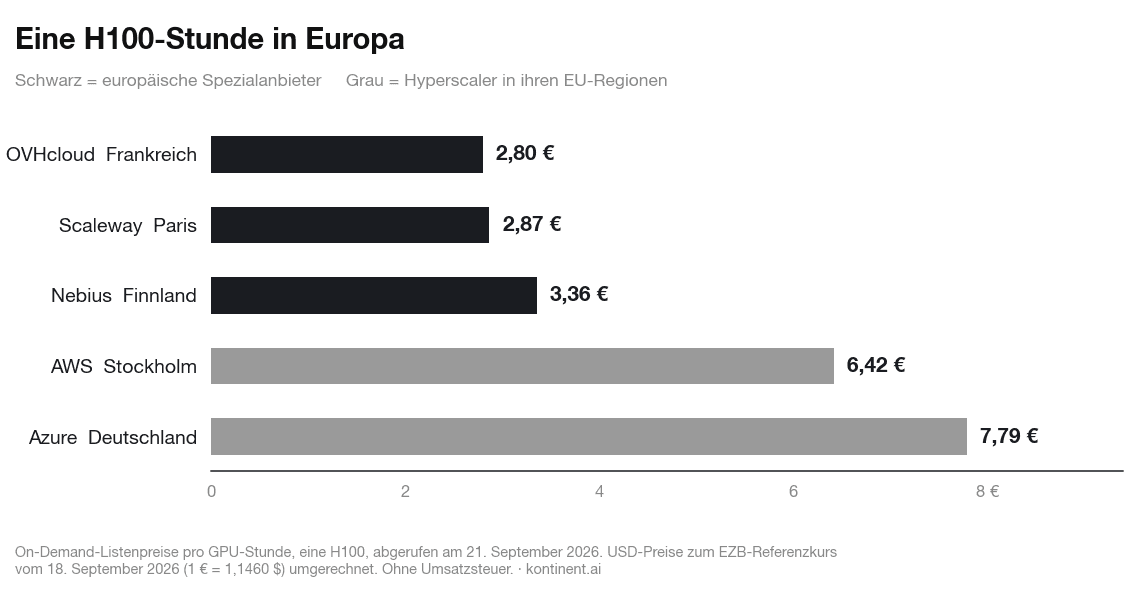
Der Abstand ist kein Rundungsfehler. Azure verlangt in Deutschland für eine einzelne H100 fast das Dreifache dessen, was OVHcloud in Frankreich aufruft. Und er wächst mit der Größe des Systems: Ein Acht-GPU-Knoten mit H100 SXM kostet bei Scaleway 25,33 Euro pro Stunde, also 3,17 Euro pro GPU. Dieselbe Bauform kostet bei Azure in Westeuropa 109,75 Euro pro Stunde, also 13,72 Euro pro GPU.
Anbieter | Sitz und Region | Konfiguration | Listenpreis pro Stunde |
|---|---|---|---|
OVHcloud | Frankreich | 1× H100 80 GB | 2,80 € |
OVHcloud | Frankreich | 1× A100 80 GB | 2,75 € |
OVHcloud | Frankreich | 8× H200 141 GB | 42,00 € (5,25 € je GPU) |
Scaleway | Frankreich, Paris | 1× H100 PCIe 80 GB | 2,87 € |
Scaleway | Frankreich, Paris | 8× H100 SXM 80 GB | 25,33 € (3,17 € je GPU) |
Scaleway | Frankreich, Paris | 8× B300 SXM | 60,00 € (7,50 € je GPU) |
Nebius | Niederlande, Rechenzentrum Finnland | H100, On-Demand | 3,85 $ (preemptible 2,15 $) |
Nebius | Niederlande, Rechenzentrum Finnland | H200, On-Demand | 4,50 $ (preemptible 2,45 $) |
Azure | USA, Region Deutschland West-Mitte | 1× H100 NVL (NC40ads H100 v5) | 7,79 € |
Azure | USA, Region Westeuropa | 8× H100 SXM (ND96isr H100 v5) | 109,75 € (13,72 € je GPU) |
AWS | USA, Region Stockholm | 1× H100 (p5.4xlarge) | 7,36 $ |
AWS | USA, Region Spanien | 8× H200 (p5en.48xlarge) | 68,36 $ (8,55 $ je GPU) |
AWS | USA, Region Frankfurt | keine H100 im Preisverzeichnis, nur 8× A100 40 GB | 27,43 $ |
Die letzte Zeile ist die, die in Kundengesprächen regelmäßig für Überraschung sorgt. Wer selbstverständlich davon ausgeht, in Frankfurt auf H100 trainieren zu können, weil AWS dort ein großes Rechenzentrum betreibt, findet im On-Demand-Preisverzeichnis für eu-central-1 keine p5-Instanz. Die nächstbeste Trainings-GPU dort ist die A100 mit 40 GB. H100 gibt es in der EU bei AWS in Stockholm, H200 in Spanien. Für ein Projekt mit der Auflage „Daten bleiben in Deutschland" ist das ein hartes Ausschlusskriterium, und es fällt meist erst auf, wenn die Architektur schon steht.
Zwei Hinweise zu den Zahlen. Es sind Listenpreise ohne Rabatt, ohne Reservierung und ohne Umsatzsteuer, und sie decken nur die GPU ab. Storage, ausgehender Traffic und ein Netzwerk zwischen den Knoten kommen dazu. Die US-Dollar-Werte im Diagramm haben wir zum EZB-Referenzkurs vom 18. September 2026 umgerechnet, 1 Euro entspricht 1,1460 US-Dollar.
Weg 3: EuroHPC AI Factories
Es gibt in Europa öffentliche Rechenkapazität, die viele Unternehmen nicht auf dem Schirm haben. Das EuroHPC Joint Undertaking hat inzwischen 19 AI Factories und 13 AI Factory Antennas benannt, verteilt unter anderem auf Finnland, Deutschland, Frankreich, Italien, Spanien, Schweden, Luxemburg, Griechenland, Slowenien, Bulgarien, Österreich, Tschechien, Litauen, die Niederlande, Polen und Rumänien.
Der Zugang ist gestaffelt. Playground Access gibt kleine Kontingente für den Einstieg, Fast Lane Access bis zu 50.000 GPU-Stunden, Large Scale Access mehr als das. Alle drei sind kostenfrei. Dazu kommt eine Schiene für Forschung und geförderte Verbundprojekte.
Die Einschränkung steht in der Zugangsbedingung selbst: Die kostenfreien Innovationsschienen richten sich an KMU und Startups im Bereich KI. Ein Konzern mit 4.000 Mitarbeitern fällt nicht darunter, für gewerbliche Nutzung außerhalb dieser Kategorien gilt ein Bezahlmodell. Wer die Kriterien erfüllt, bekommt hier allerdings Rechenzeit in einer Größenordnung, die über jedem sinnvollen Cloud-Budget liegt. JUPITER in Jülich, seit November 2025 offiziell in Betrieb, ist Europas erster Exascale-Rechner und arbeitet mit rund 24.000 GH200-Superchips.
Realistisch ist das kein Weg für einen schnellen Test. Anträge dauern, und die Umgebung ist ein HPC-Cluster mit Slurm und Modulsystem. Wer eine Cloud-VM mit SSH und root erwartet, bringt das falsche Werkzeug mit. Für ein geplantes, größeres Vorhaben lohnt der Blick trotzdem, allein weil die Alternative aus dem Budget kommt.
Weg 4: Eigene Hardware
Der vierte Weg ist der, über den am meisten geredet und am wenigsten gerechnet wird. Eine eigene GPU im eigenen Rack löst jede Residenzfrage auf einen Schlag, und es gibt Branchen, in denen genau das die Auflage ist.
Die Rechnung ist einfach genug, um sie selbst aufzustellen. Eine H100-Stunde kostet bei OVHcloud 2,80 Euro. Ein ganzes Jahr Dauerbetrieb, 8.760 Stunden, kostet damit rund 24.500 Euro. Das ist die Zahl, gegen die Ihre eigene Hardware antreten muss, inklusive Beschaffung, Abschreibung, Strom, Kühlung, Rack und der Person, die das Ding betreibt. Der entscheidende Faktor ist die Auslastung: Fine-Tuning-Läufe sind selten Dauerlast. Wer alle zwei Monate zwölf Stunden trainiert, kauft sich eine Maschine, die 99 Prozent der Zeit Strom verbraucht.
Anders sieht es aus, wenn nach dem Training dauerhafte Inferenz auf derselben Hardware läuft. Dann wird aus einem sporadisch genutzten Trainingsrechner ein permanent ausgelasteter Inferenzserver, und die Rechnung dreht sich. Die im Netz kursierenden Break-even-Zahlen für Self-Hosting gegen Token-Preise widersprechen sich um Größenordnungen, deshalb steht hier keine. Rechnen Sie mit Ihren eigenen Volumina, den Preisen oben und einer ehrlichen Annahme zur Auslastung.
Welche Maschine ein Lauf wirklich braucht
Bevor Sie einen Anbieter wählen, sollten Sie wissen, welche Maschine Sie überhaupt brauchen. Die Antwort fällt oft kleiner aus als erwartet, und das liegt an LoRA.
LoRA friert die Gewichte des Basismodells ein und trainiert nur kleine Low-Rank-Matrizen dazu. Die Originalarbeit von Hu et al. berichtet für GPT-3 mit 175B Parametern eine Reduktion der trainierbaren Parameter um den Faktor 10.000 und einen um den Faktor drei geringeren GPU-Speicherbedarf gegenüber vollem Fine-Tuning mit Adam. QLoRA quantisiert das eingefrorene Basismodell zusätzlich auf 4 Bit. Dettmers et al. zeigten damit das Fine-Tuning eines 65B-Modells auf einer einzelnen 48-GB-GPU bei gleichbleibender Qualität gegenüber vollem 16-Bit-Training.
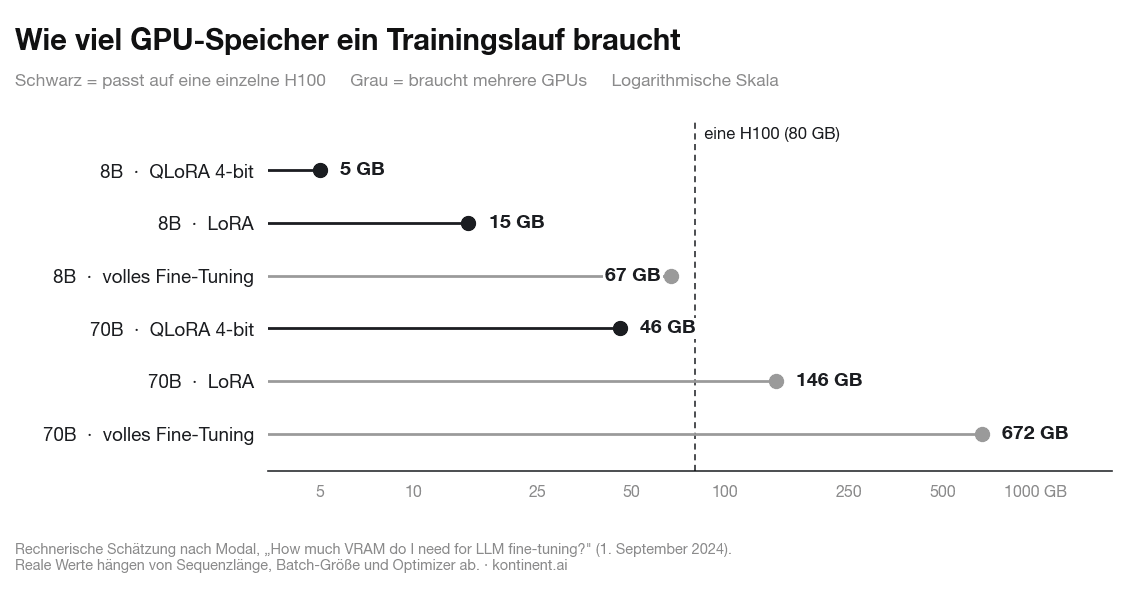
Die praktische Folge: Ein 70B-Modell mit QLoRA braucht nach dieser Rechnung rund 46 GB und passt damit auf eine einzelne H100 mit 80 GB. Volles Fine-Tuning desselben Modells braucht etwa 672 GB und damit einen Acht-GPU-Knoten. Zwischen diesen beiden Optionen liegen bei Scaleway knapp Faktor neun im Preis.
Ob LoRA qualitativ reicht, ist inzwischen gut untersucht. John Schulman und Thinking Machines haben die Bedingungen 2025 zusammengetragen: LoRA erreicht die Qualität vollen Fine-Tunings beim Instruction-Tuning und beim Reasoning, solange der Datensatz die Kapazität der Adapter nicht übersteigt und die Adapter auf allen Layern sitzen, MLP eingeschlossen. Wer LoRA nur auf die Attention-Layer legt, verliert messbar, auch bei gleicher Parameterzahl. Die Learning Rate muss ungefähr zehnmal höher liegen als beim vollen Fine-Tuning. Im RL-Post-Training reicht LoRA schon bei sehr kleinem Rank, weil eine Policy-Gradient-Aktualisierung pro Token rund tausendmal weniger Information trägt als ein SFT-Schritt.
Dass LoRA ausreichend mächtig ist, zeigt auch die unangenehme Seite dieser Forschung. Lermen et al. entfernten mit LoRA auf einer einzelnen GPU und für weniger als 200 US-Dollar das Safety-Training aus Llama-2-Chat-70B, bis die Ablehnungsrate auf etwa ein Prozent fiel, während die allgemeinen Benchmarks stabil blieben. Wer trainiert, verändert Verhalten, und zwar auch das Verhalten, das er nicht anfassen wollte.
Was ein Trainingslauf am Ende kostet
Zur Dauer eines Laufs gibt es keine sauberen Benchmarks. Was es gibt, sind Erfahrungswerte aus der Praxis. Die folgenden Angaben stammen aus Berichten von Praktikern, nicht aus einer kontrollierten Messung, und sind entsprechend grob. Die Preise dagegen sind die oben geprüften.
Lauf | Berichtete Dauer | Maschine | Rechenkosten in Europa |
|---|---|---|---|
8B, QLoRA, rund 10.000 Beispiele | unter 2 Stunden | 1× A100 | etwa 6 € |
70B, QLoRA | 8 bis 12 Stunden | 1× H100 | 22 bis 34 € |
70B, volles Fine-Tuning | 24 bis 48 Stunden | 8× H100 SXM | 610 bis 1.220 € |
Die Größenordnung ist die eigentliche Aussage. Ein erster ernsthafter Fine-Tuning-Versuch auf europäischer Hardware kostet an Rechenzeit weniger als ein Tag Beratung. Das Budget geht woanders hin: in die Aufbereitung und Bereinigung der Trainingsdaten, in ein Testset, dem man glaubt, und in die Läufe, die man wegwirft. Rechnen Sie mit mehreren Versuchen, nicht mit einem.
Und rechnen Sie den Betrieb danach ein. Ein eigenes Modell muss laufen, üblicherweise unter vLLM oder TGI, und dann zahlen Sie GPU-Stunden auch dann, wenn gerade niemand eine Anfrage schickt. Das ist der Punkt, an dem aus einem Trainingsprojekt eine Betriebsentscheidung wird.
Welches Basismodell Sie nehmen können
Fine-Tuning setzt voraus, dass Sie die Gewichte des Basismodells haben und die Lizenz Ihnen erlaubt, sie zu verändern und das Ergebnis kommerziell zu betreiben. Apache 2.0 und MIT sind dabei die ruhigen Fälle. Europa hat davon mehr, als die Diskussion vermuten lässt.
Modell | Herkunft | Größen | Lizenz |
|---|---|---|---|
Mistral Large 3 | Frankreich | 675B MoE, davon rund 41B aktiv | Apache 2.0 |
Ministral 3 | Frankreich | 14B, 8B, 3B | Apache 2.0 |
Mistral Small 4 | Frankreich | kompakt, Instruct und Reasoning in einem Modell | Apache 2.0 |
Apertus | Schweiz, EPFL und ETH Zürich | 70B, 8B | Apache 2.0 |
EuroLLM | EU-Konsortium um Unbabel und IST Lissabon | 22B, 9B, 1,7B | Apache 2.0 |
Salamandra und ALIA-40B | Spanien, Barcelona Supercomputing Center | 40B, 7B, 2B | Apache 2.0 |
Teuken-7B | Deutschland, OpenGPT-X | 7B | Apache 2.0 in der kommerziellen Variante |
Zwei Dinge sollte man dabei auseinanderhalten. Erstens ist nicht jedes Modell eines europäischen Anbieters offen. Mistral Medium 3.5 steht unter einer eigenen Lizenz, mehrere Small-Varianten laufen unter dem Premier-Label. Die Herkunft des Anbieters sagt nichts über die Lizenz.
Zweitens ist ein europäisches Basismodell keine Voraussetzung für Souveränität. Ein Llama oder Qwen mit offenen Gewichten läuft auf einer H100 in Gravelines genauso wie ein Mistral, und nach dem Download findet keine Kommunikation mehr mit dem Hersteller statt. Was Sie prüfen müssen, sind die Lizenzbedingungen, die bei Llama und Gemma über Apache 2.0 hinausgehen, etwa Namenspflichten für abgeleitete Modelle. Souveränität entsteht am Betriebsort. Die Postanschrift des Trainingslabors ändert daran nichts.
Sprachabdeckung ist der Punkt, an dem europäische Modelle tatsächlich einen eigenen Vorteil haben. Teuken-7B, EuroLLM und Salamandra sind explizit auf die Amtssprachen der EU trainiert. Ob sich das auf Ihre Aufgabe auswirkt, sagt Ihnen nur ein Test auf Ihren eigenen Daten.
Wo die Gewichte liegen, und warum das die eigentliche Frage ist
Bis hierhin klang „wem gehören die Gewichte" nach einer Frage der Unabhängigkeit vom Anbieter. Der Rückbau der OpenAI-Plattform zeigt, dass diese Frage praktisch wird, und zwar schneller als die Abschreibungsdauer eines Trainingsprojekts. Sie ist außerdem eine datenschutzrechtliche.
Ein auf Ihren Daten trainiertes Modell kann Trainingsdaten wieder ausgeben. Die Forschung dazu ist eindeutiger, als es vielen lieb ist: Für Training-Data-Extraction-Angriffe auf fine-getunte Modelle existiert derzeit keine praktikable Verteidigung mit belastbaren theoretischen Garantien. Differential Privacy dämpft das Risiko, kostet aber spürbar Qualität. Gleichzeitig entstehen neue Angriffsklassen, etwa Prompts, die gezielt Zustände hoher Unsicherheit herbeiführen, um memorierte Passagen hervorzulocken.
Damit wird der Speicherort der Gewichtsdatei zu einer Frage, die Sie beantworten können müssen. Liegt die Datei in Ihrem eigenen Storage in der EU, ist sie ein Asset wie eine Datenbank. Liegt sie in einem fremden System, dessen Betreiber Sie nicht kennen, ist sie ein offenes Ende in Ihrem Verzeichnis von Verarbeitungstätigkeiten. Welche Rechtsgrundlage das Training trägt, wann ein Modell überhaupt noch Personenbezug hat und was bei einem Löschantrag nach dem Lauf passiert, haben wir mit Fundstellen aufgeschrieben.
Praktisch folgt daraus eine kurze Liste: Klären Sie vor dem ersten Lauf, wo die Artefakte landen, wer außer Ihnen darauf zugreifen kann, wie lange Zwischenstände aufbewahrt werden und ob Sie am Ende eine Datei bekommen oder nur einen Endpoint.
Was der AI Act daran ändert
Weniger, als die meisten befürchten. Die Sorge, durch Fine-Tuning selbst zum Anbieter eines GPAI-Modells zu werden und damit die vollen Pflichten aus dem AI Act zu erben, löst sich bei genauerem Hinsehen meist auf.
Die Kommission hat in ihren Leitlinien vom 18. Juli 2025 eine Faustregel gesetzt: Eine wesentliche Änderung wird in der Regel erst dann angenommen, wenn die Modifikation mehr als ein Drittel der Trainingsrechenleistung des Originalmodells verbraucht. Ist diese Rechenleistung unbekannt, greifen Ersatzschwellen, abgeleitet von den Schwellen, die ein Modell überhaupt erst zum GPAI-Modell machen. Ein LoRA-Lauf über zwölf Stunden auf einer H100 liegt um viele Größenordnungen darunter.
Für Sie gelten damit in aller Regel die Pflichten des Betreibers. Die Details und die aktuellen Fristen nach dem Digital Omnibus stehen im Beitrag zum Rechtsrahmen.
Evaluation: messen Sie auf Deutsch
Ein Trainingslauf ohne Eval ist eine Meinung. Das Standardwerkzeug ist lm-evaluation-harness von EleutherAI, das über 200 Tasks abdeckt und sowohl lokale Modelle als auch OpenAI-kompatible Endpoints ansprechen kann. HELM aus Stanford und LightEval von Hugging Face decken denselben Zweck mit anderem Schwerpunkt ab.
Für deutschsprachige Anwendungen gibt es zwei Ergänzungen, die sich lohnen. SuperGLEBer bündelt 29 Aufgaben zum deutschen Sprachverständnis, von Dokumentklassifikation über Sequence Tagging bis Question Answering, und ist auf der NAACL 2024 veröffentlicht. Das Occiglot-Projekt pflegt ein Euro-LLM-Leaderboard mit deutschsprachigen Varianten gängiger Benchmarks.
Ein methodischer Haken ist dabei bekannt und wird zu selten erwähnt: Viele deutsche Benchmarks sind aus dem Englischen maschinell übersetzt. Sie messen dann eher Übersetzungsartefakte als deutsche Sprachkompetenz. Für eine Kaufentscheidung reicht das nicht. Was am Ende zählt, ist ein Testset aus Ihren eigenen Fällen, von Ihren eigenen Leuten gelabelt, und zwar bevor der erste Lauf startet.
Wie wir das mit Ihnen durchgehen
Wenn bei Ihnen ein Trainingsprojekt ansteht, gehen wir Ihren Fall in 30 Minuten durch: welcher der vier Wege zu Ihrer Auflagenlage passt, welches Basismodell lizenzrechtlich sauber ist, was der Lauf ungefähr kostet und wo die Gewichte hinterher liegen. Engineering ist dabei. Wenn die Antwort lautet, dass ein Prompt und ein RAG-Index Ihr Problem billiger lösen, sagen wir das. Demo buchen.
Häufige Fragen
Kann ich ein LLM in Europa DSGVO-konform fine-tunen?
Ja. Nötig sind eine tragfähige Rechtsgrundlage für die Weiterverarbeitung Ihrer Daten, ein Anbieter mit AVV und EU-Rechenzentrum für den Lauf selbst und eine Entscheidung darüber, wo die fertigen Gewichte liegen. Der dritte Punkt fehlt in den meisten Setups. Die rechtliche Seite ist im Beitrag zu DSGVO und AI Act mit Fundstellen aufgeschrieben.
Was kostet Fine-Tuning in Europa?
Die Rechenzeit ist günstig. Ein QLoRA-Lauf auf einem 70B-Modell dauert nach Praktikerberichten 8 bis 12 Stunden auf einer einzelnen H100 und kostet bei einem Listenpreis von 2,80 Euro pro Stunde rund 22 bis 34 Euro. Volles Fine-Tuning desselben Modells auf acht H100 liegt bei 610 bis 1.220 Euro. Der größere Posten sind Datenaufbereitung, Evaluation und die Läufe, die nicht funktionieren.
Welche europäischen Anbieter bieten GPUs für Fine-Tuning?
OVHcloud und Scaleway aus Frankreich sowie Nebius mit Rechenzentrum in Finnland bieten H100 und neuere Karten stundenweise an, mit Listenpreisen zwischen 2,80 und 3,85 Euro beziehungsweise US-Dollar pro GPU-Stunde. Dazu kommen IONOS mit Servern in Deutschland und, für qualifizierte KMU, die EuroHPC AI Factories.
Brauche ich ein europäisches Basismodell?
Nein. Entscheidend ist, wo das Modell läuft und wo die Gewichte liegen. Ein Modell mit offenen Gewichten kommuniziert nach dem Download nicht mehr mit seinem Hersteller. Prüfen sollten Sie die Lizenz: Apache 2.0 und MIT sind unkompliziert, Llama und Gemma bringen zusätzliche Auflagen mit.
Bekomme ich die Gewichte, wenn ich eine Fine-Tuning-API nutze?
Das hängt vom Anbieter ab und gehört vor den ersten Job geklärt. OpenAI stellt für fine-getunte Modelle keine Gewichte zum Download bereit und baut die Plattform inzwischen ohnehin zurück, für neue Nutzer ist sie laut Dokumentation geschlossen. Plattformen für offene Modelle geben die trainierten Adapter häufig heraus. Ohne eigene Datei sind Sie an den Lebenszyklus des Anbieters gebunden.
Können wir Rechenzeit bei EuroHPC nutzen?
Wenn Sie ein KMU oder Startup im KI-Bereich sind, ja, und zwar kostenfrei. Fast Lane Access reicht bis zu 50.000 GPU-Stunden, Large Scale Access darüber hinaus. Größere Unternehmen fallen nicht unter die kostenfreien Innovationsschienen. Planen Sie Vorlauf für den Antrag ein und rechnen Sie mit einer HPC-Umgebung statt mit einer Cloud-VM.
Reicht eine einzelne GPU für ein 70B-Modell?
Für QLoRA ja. Der Speicherbedarf liegt rechnerisch bei rund 46 GB und passt damit auf eine H100 mit 80 GB. LoRA in 16 Bit braucht etwa 146 GB, volles Fine-Tuning rund 672 GB und damit einen Acht-GPU-Knoten. Die realen Werte hängen von Sequenzlänge, Batch-Größe und Optimizer ab.
Werde ich durch Fine-Tuning zum Anbieter nach dem EU AI Act?
In aller Regel nicht. Die Leitlinien der Kommission vom Juli 2025 nehmen eine wesentliche Änderung erst an, wenn die Modifikation mehr als ein Drittel der Trainingsrechenleistung des Originalmodells verbraucht. Kein übliches Fine-Tuning auf Unternehmensdaten kommt in diese Nähe.
Quellen
OVHcloud, Public-Cloud-Preise, Werte aus dem öffentlichen Bestellkatalog für Deutschland, abgerufen am 21. September 2026
Scaleway, GPU-Preise, Zone PAR-2, abgerufen am 21. September 2026
Nebius, Preisübersicht, abgerufen am 21. September 2026
Microsoft Azure Retail Prices API, Regionen Deutschland West-Mitte, Westeuropa und Schweden Mitte, abgerufen am 21. September 2026
AWS EC2 On-Demand-Preise, Werte aus der Price-List-API für eu-central-1, eu-north-1, eu-west-1 und eu-south-2, abgerufen am 21. September 2026
OpenAI, Supervised Fine-Tuning mit dem Hinweis zum Rückbau der Plattform, OpenAI, API-Preise, Fireworks AI, Preise und Together AI, Preise für Fine-Tuning nach Trainings-Tokens
Mistral, Fine-Tuning-Dokumentation (mit Deprecation-Hinweis) und Mistral, Modellübersicht mit Lizenzen
EuroHPC JU zu JUPITER, 17. November 2025
Hu et al., LoRA: Low-Rank Adaptation of Large Language Models (arXiv 2106.09685) und Dettmers et al., QLoRA (arXiv 2305.14314)
John Schulman und Thinking Machines Lab, LoRA Without Regret, 29. September 2025
Modal, How much VRAM do I need for LLM fine-tuning?, 1. September 2024, Grundlage der Speicherwerte im Diagramm
Lermen et al., LoRA Fine-tuning Efficiently Undoes Safety Training in Llama 2-Chat 70B (arXiv 2310.20624)
Retracing the Past: LLMs Emit Training Data When They Get Lost (arXiv 2511.05518) zur Extraktion von Trainingsdaten
Europäische Kommission, Leitlinien zum Anwendungsbereich der Pflichten für GPAI-Anbieter, 18. Juli 2025, mit der Drittel-Schwelle für Modifikationen
SuperGLEBer, German Language Understanding Evaluation Benchmark (NAACL 2024), Occiglot und lm-evaluation-harness
Mistral AI zu Mistral Large 3 und Ministral 3, ETH Zürich zu Apertus, EuroLLM, Salamandra und ALIA sowie OpenGPT-X zu Teuken-7B
Stand: 21. September 2026 · kontinent.ai. Alle Preise am 21. September 2026 aus den Preisverzeichnissen der Anbieter abgerufen, Listenpreise ohne Rabatte und ohne Umsatzsteuer. US-Dollar-Werte zum EZB-Referenzkurs vom 18. September 2026 umgerechnet. GPU-Preise ändern sich häufig, prüfen Sie vor einer Entscheidung das Originalverzeichnis. Keine Rechtsberatung.
